Deja de pedirles a los agentes que trabajen como humanos
Antecedentes
Para comenzar, voy a hablar de cuando, como desarrolladores, descubrimos ChatGPT, aproximadamente durante la generación de GPT-3.5 y el paso a GPT-4.
Comenzamos a darnos cuenta de que, además de escribir código por nosotros, que en ese tiempo copiábamos y pegábamos desde ChatGPT, también podía encargarse de otro trabajo documental que solíamos hacer: generar reportes, hacer presentaciones, llenar documentos para managers y otros equipos, y escribir documentación del proyecto, documentación técnica y diseños técnicos.
Recuerdo que varias personas en el equipo comenzaban a escribir historias de usuario y épicas que originalmente tal vez estaban vagamente definidas. Muchas personas deseaban tener historias de usuario altamente definidas. Aunque eso pudiera considerarse una mala práctica por los autores originales de estas técnicas en Agile, los equipos de desarrollo pedían tener definiciones muy amplias dentro de las historias de usuario.
Y ahí aparece una de las grandes habilidades de los LLMs: escribir mucho, ¿no? Al día de hoy, eso es también uno de los elementos de controversia más grandes: le preguntas una cosa y termina dándote un miniartículo para cada respuesta.
El siguiente paso natural era empezar a meter agentes como un medio de trabajo. Muchas aplicaciones comenzaron a integrar sus chatbots. Entonces tú abrías el chatbot y de pronto ya tenías algo muy similar a ChatGPT dentro de la página de alguna empresa.
La ventaja que se suponía que estos agentes ofrecían dentro de estas aplicaciones era que estaban conectados a la información de la empresa. Entonces podían resolver o hacer tareas para ti que estuvieran relacionadas con ese contexto.
El contexto es básicamente el rey siempre que hablamos del tema de agentes. Entonces todo lo que ayude a darle al agente el contexto más adecuado lo va a hacer trabajar de la mejor forma.
Cuando el agente imita nuestro trabajo
Ahí es donde comenzamos a delegarle al agente trabajo que imitara a otros humanos. Entonces teníamos pequeños agentes que fueran nuestros project managers, product managers, technical writers, etcétera. Todo ese trabajo que no quería hacer el humano escribiendo documentación extensa lo terminaba haciendo el agente.
Y hemos llegado al punto de que hoy en día nos negamos hasta a leer texto generado por agentes. Escribir se ha mantenido como uno de los medios que usamos para comunicarnos con otros humanos. Entonces, cuando una persona ve que otra le ofrece contenido escrito por AI, puede rechazarlo. No todos reaccionamos igual, pero para algunos basta con leer las primeras frases de un artículo escrito 100% con AI para generar un rechazo inmediato.
La documentación como parte del flujo de trabajo
Aquí es donde aparece un punto de inflexión en la forma de escribir código o hacer trabajo con agentes. Empezamos a reevaluar qué debería estar haciendo el agente por nosotros, si al final estamos usando el trabajo que genera como una muleta para luego hacer que se comporte como humano.
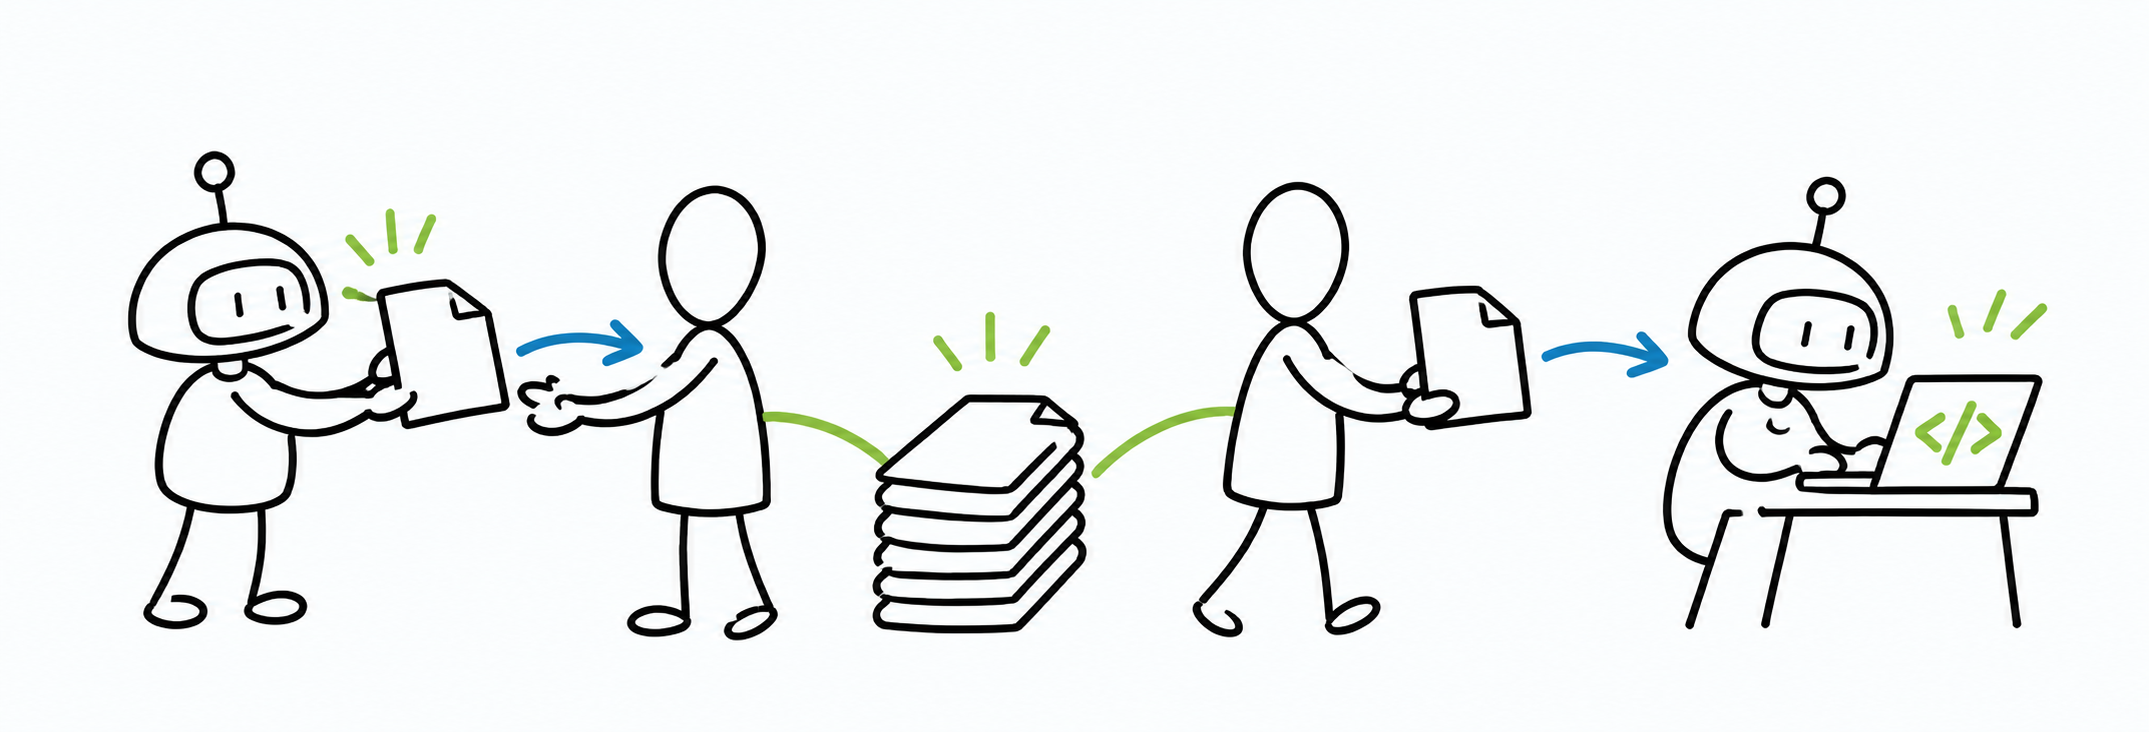
Y me explico: para ejecutar una tarea de programación, por ejemplo, probablemente en tu organización usen al agente para definir historias de usuario, épicas o cualquier marco o framework que utilices para trabajar. Lo pones a escribir diseños técnicos para posteriormente presentarlos a algún manager, buscar alguna aprobación, compartirlos con el equipo y comenzar la implementación, que nuevamente estará haciendo el agente.
Entonces, toda esa documentación intermedia fue creada como una muleta para introducir al agente a tu flujo de trabajo. Algunas personas lo utilizan como excusa para decir que es el human in the loop.
Mi argumento aquí, o mi tesis, es que resulta equivocado poner a trabajar al agente como muleta para hacer lo que los humanos están haciendo. Lo que en realidad deberíamos estar haciendo es eliminar todos esos procesos que ya no necesitan al humano en medio o no forzarnos a tratar de entrometernos en el trabajo del agente.
El trabajo de los agentes ha cambiado drásticamente desde inicios de 2026. Leyendo el último artículo que escribí sobre la forma en la que trabajo con agentes, veo que en menos de un año quedó completamente desactualizado. Y esa era la segunda vez que escribía ese artículo.
Entonces, en esta ocasión, quiero repensar las cosas que le pedimos al agente que haga imitando al humano, como una muleta para las cosas que todavía no sabemos cómo eliminar de nuestro proceso. Y este es uno de los cambios más trascendentales que estaremos viendo próximamente. Probablemente, cuando vuelva a leer este artículo en unos seis meses, me daré cuenta de que estas prácticas también han quedado desactualizadas.
Comentarios y explicaciones que repiten el código
Entre estas prácticas podemos hablar también de la forma en la que escribíamos código. Yo recuerdo que le pedía al agente agarrar una clase y llenarla de un montón de documentación, comentarios JSDoc o XMLDocs en el caso de .NET, solo porque a mí estéticamente me gusta y se me hace más legible ese tipo de código, no porque realmente estuviera leyendo esos comentarios. Comentarios que rápidamente también se vuelven obsoletos si simplemente imitan o describen lo que está haciendo el código.
Y aquí viene una parte muy importante. Cuando nosotros le pedimos al agente que explique una clase o un programa, usualmente lo hace de una forma muy tautológica. Básicamente, es lo mismo que está escrito en código, pero en el idioma que tú hables, ya sea inglés o español. Si el código cambia, la narrativa va a cambiar. Si tú le pides al agente que explique código, no te dará una gran explicación, solo repetirá lo que está escrito en código. Tienes que buscar técnicas para que el agente realmente te dé una explicación valiosa.
Una gran explicación no se hace imitando lo que hace el código. Para eso, mejor leo directamente el código. Lo mismo ocurre con las buenas pruebas: no necesitan imitar la implementación.
Ahí es donde el buen diseño de pruebas también entra en juego, porque si el código cambia por un refactor, las pruebas no deberían cambiar, así como la explicación tampoco debería cambiar.
Entonces, todo lo que escribíamos en documentos XML generados por agentes también era simplemente tokens quemados durante el desarrollo. Repensemos las prácticas que hacíamos de programación, porque comienza a perder sentido que el código mismo incluya esos comentarios XML, headers de documentación, etcétera, cuando finalmente tú puedes preguntarle directamente al agente.
A mí me daba mucha ilusión un proyecto llamado OpenWiki, al cual le dabas una base de código y generaba documentación de esa misma base de código. Sin embargo, ahora que lo pienso bien, hasta ese tipo de proyectos pierden el sentido, pues, finalmente, ¿quién va a leer esa documentación? Absolutamente nadie, e inclusive es mejor que el agente lea el código directamente.
Si tú quieres pedirle al agente que implemente una librería, le das el repositorio.
La documentación que aporta contexto
Eso no quiere decir que eliminemos toda la documentación, los comentarios y otros artefactos que rodean al código, como los diseños técnicos. Nuevamente, se trata de repensarlos.
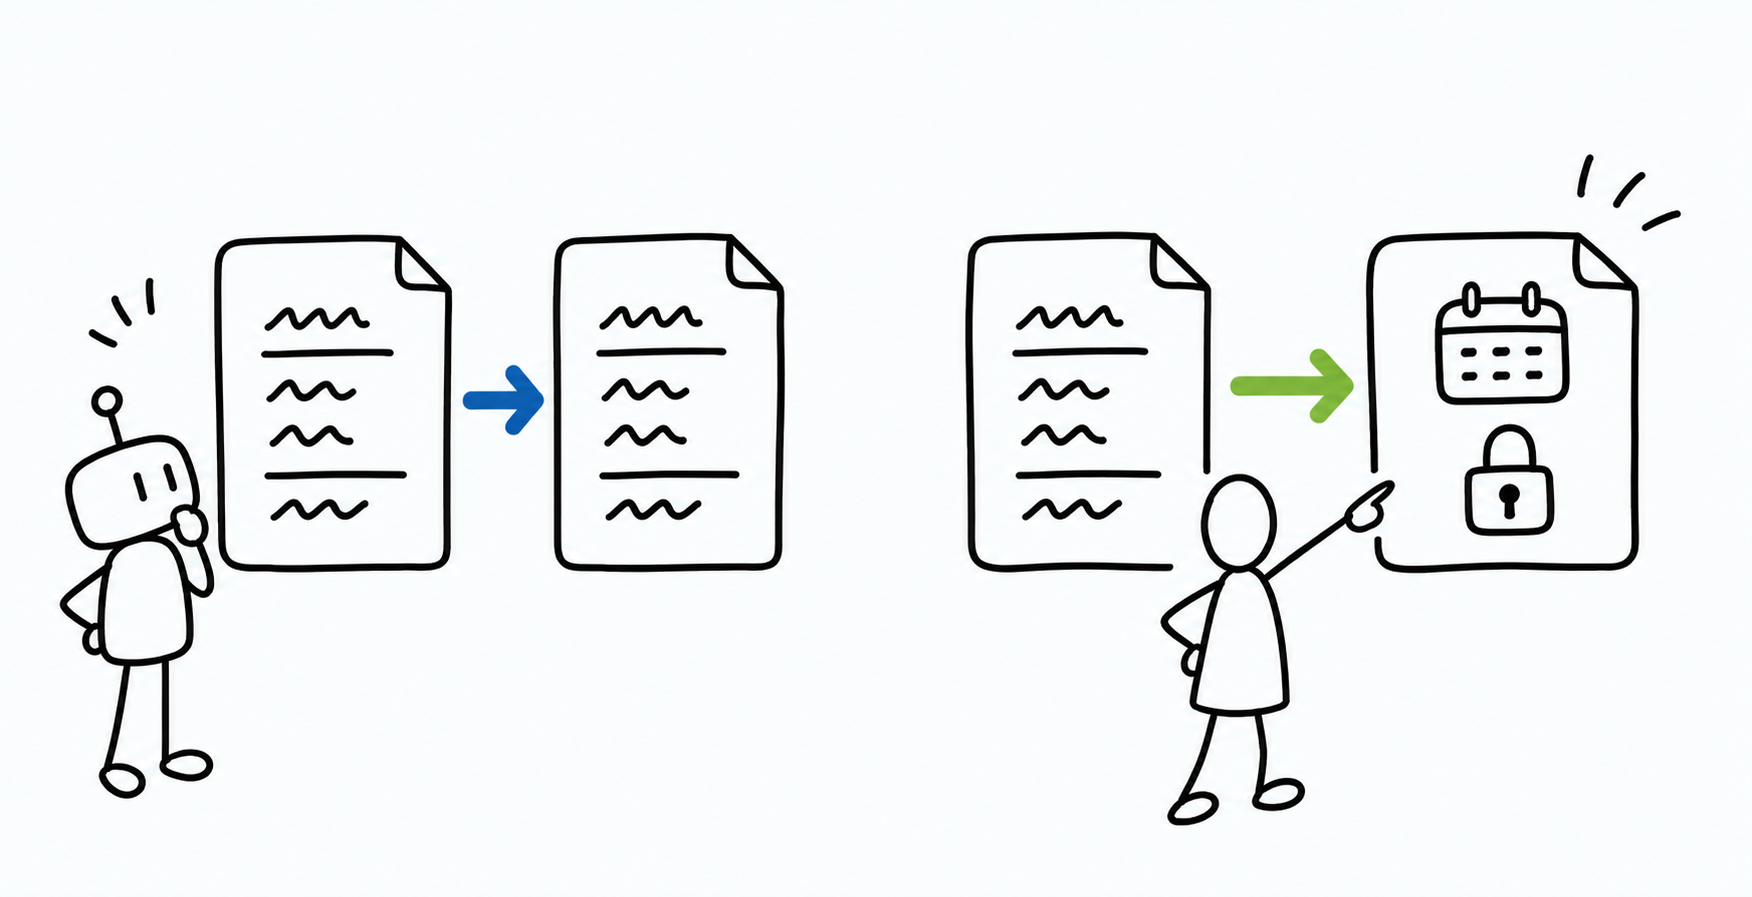
Algo que sí se justifica bien, como en el ejemplo anterior: si el código cambia y la explicación no, entonces la explicación tiene sentido. La explicación muchas veces tiene que acompañar al código para darle sentido a cómo diferentes componentes pueden entrelazarse.
Este puede ser contexto de dominio o de negocio: cosas que el agente no puede voltear y ver directamente porque viven en la mente de los stakeholders y dueños del negocio. Entonces tú le agregas ese contexto adicional al agente para que entienda cuál es el fin de su trabajo.
Planeación y artefactos para agentes
Entre otras prácticas, Matt Pocock tiene un pack de skills. Incluye el proceso de generar especificaciones, tickets y otros artefactos para que el agente trabaje.
Eso, como decía, no quiere decir que eliminemos todos los tickets de Jira que teníamos en nuestro board. Sin embargo, hoy en día una práctica de planeación, refinamiento, etcétera, potencialmente pierde el sentido, porque finalmente tú le puedes dar al agente un trabajo sumamente complejo, refinarlo utilizando alguna de estas prácticas modernas de desarrollo agéntico, como las de pstack, de poteto, o las de Matt Pocock, aclarar los supuestos del agente y finalmente permitirle que ejecute.
Incluso los artefactos generados por estos skills no necesariamente están hechos para que los humanos los lean. Están hechos para que el agente tenga contexto de su ejecución y finalmente terminan siendo desechables. En algunos casos, nuevamente, sí hay contexto y documentación que va a acompañar al código a largo plazo, pero no necesariamente todas estas explicaciones.
Entonces, poner al agente a actuar como persona, creando tickets, documentación y diseños técnicos, pierde sentido y solo quema dinero. Sigue teniendo sentido escribir cosas humanas para otros humanos.
Verificación y herramientas reutilizables
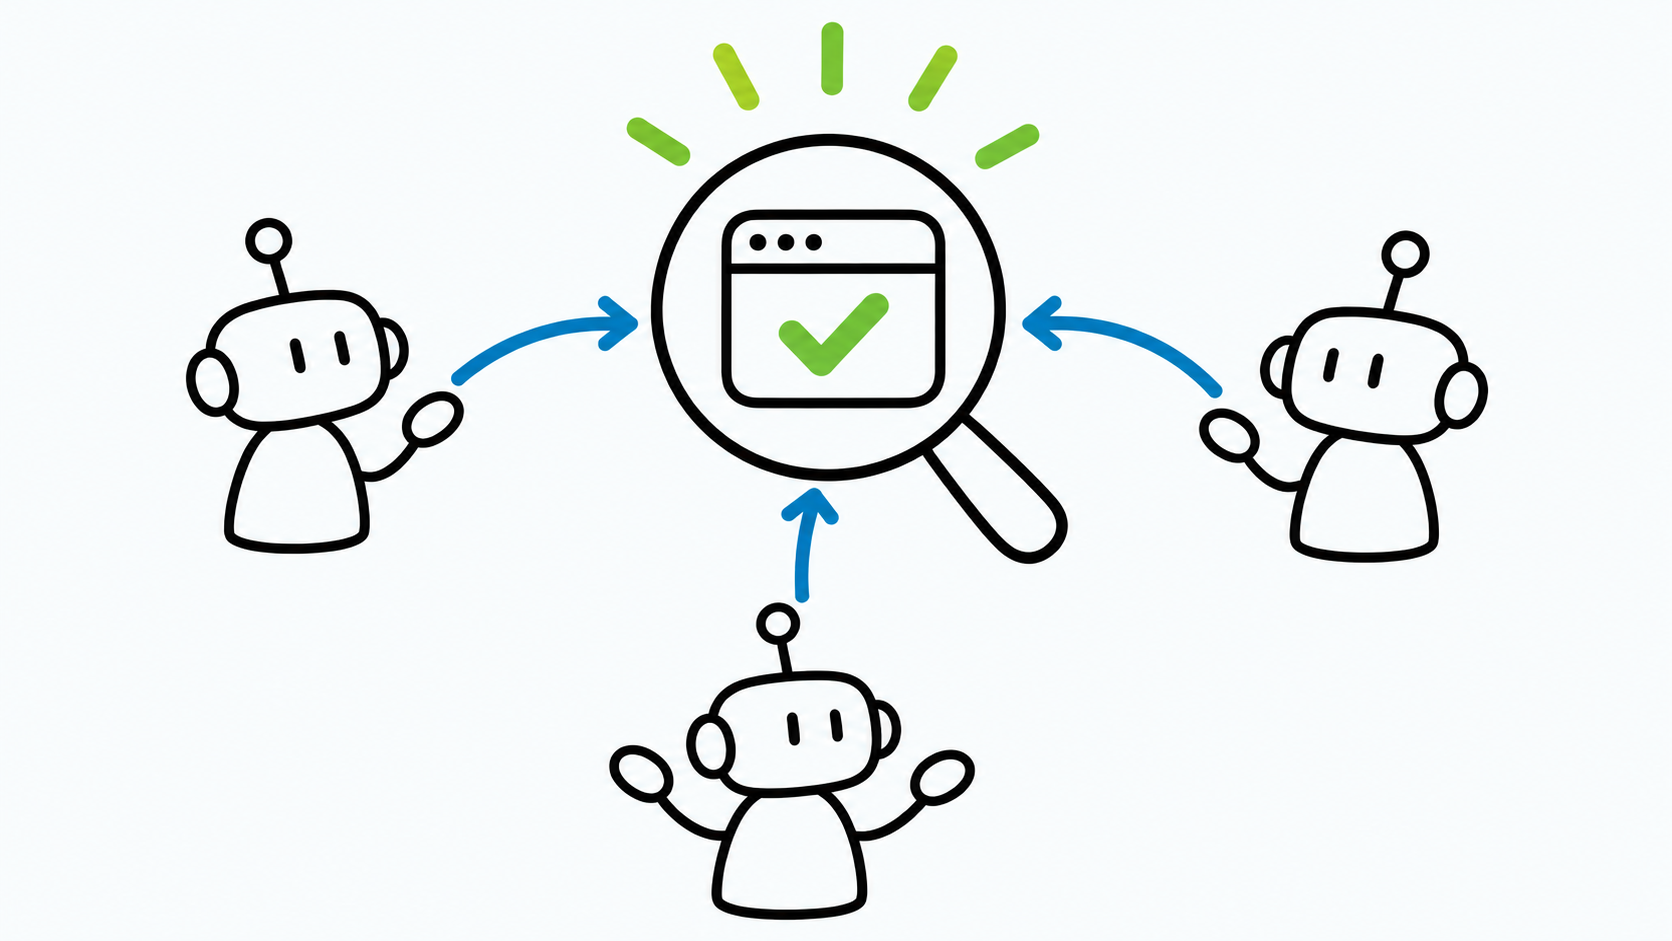
Pero dejar de entrometernos nosotros en el trabajo de los agentes también implica darles lo que necesitan para trabajar. Como explica Lauren con pstack, si el agente no tiene una forma de verificar lo que hizo, el humano termina convirtiéndose en el mecanismo de verificación para cada cambio.
Ahí es donde podemos comenzar a pensar en herramientas y conocimiento reutilizable: algo que construimos una vez y que después el agente puede volver a utilizar para entender el proyecto, ejecutar la aplicación y comprobar su trabajo.
Y creo que ese es el punto. No necesitamos conservar cada paso de nuestro proceso solo porque así trabajábamos antes. Necesitamos entender qué problema resolvía y encontrar la forma de resolverlo ahora que también trabajamos con agentes.
Portada: Frutiger Aero Archive.

Ilustraciones generadas con inteligencia artificial mediante shapeup-illustrations, con referencias visuales de Shape Up, de Ryan Singer y Basecamp.