¿Cómo utilizo Copilot para escribir código?
Conceptos clave
Antes de hablar de flujos de trabajo o trucos, hay conceptos que necesitas dominar si vas a trabajar con agentes de AI. Estos conceptos son lo que separa a alguien que obtiene resultados de mala calidad de alguien que obtiene resultados consistentemente buenos.
Contexto
El contexto es toda la información que el agente tiene disponible para entenderte y generar algo útil. Yo lo divido en dos tipos: estático y dinámico.
Contexto estático
Es todo lo que se carga siempre, desde el inicio de la conversación. El agente ya lo tiene antes de que tú escribas una sola palabra.
En Copilot, los artefactos de contexto estático incluyen:
AGENTS.md— Instrucciones a nivel de workspace que el agente lee automáticamente.copilot-instructions.md— Instrucciones globales de Copilot que aplican a todas las conversaciones.instructions.md— Instrucciones adicionales que se pueden modularizar por carpeta o propósito.- Archivos de agente (anteriormente llamados chat modes) — Definiciones de agentes personalizados que incluyen su propio texto de sistema.
Piensa en esto como la "memoria base" del agente: le dice quién es, qué reglas seguir, y cómo comportarse en tu proyecto.
Contexto dinámico
Es todo lo que el agente va descubriendo solo mientras trabaja. No está predefinido; lo adquiere conforme avanza en la tarea.
Ejemplos:
- Código fuente que el agente lee al buscar en el workspace.
- Archivos de instrucciones adicionales que descubre al navegar las carpetas (por ejemplo, archivos
instructions.mdapplyTo específicos). - Archivos
AGENTS.mdnested dentro de subcarpetas del proyecto, que el agente encuentra al explorar la estructura. - Resultados de búsquedas, errores de compilación, salidas de terminal, y cualquier otro artefacto que el agente consulte durante la sesión.
- SKILLS y MCPs, se explicarán más adelante.
Skills
Los skills son relativamente nuevos y ganaron popularidad muy rápido por lo fácil que hacen compartir contexto entre proyectos y agentes.
Para mí, los skills cambiaron por completo la forma de trabajar con agentes de AI. Cuando empecé a escribir este artículo, los skills aun no existían. Un mes después, ya definían cómo se desarrolla código con AI.
Un skill es un archivo SKILL.md que encapsula conocimiento de dominio, mejores prácticas y flujos probados para un área específica — testing, diseño técnico, performance, API design, etc.
Antes de los skills, cada proyecto tenía que reinventar sus instrucciones desde cero. Los skills resuelven eso: son portables y reutilizables. Escribes el conocimiento una vez y lo aplicas en cualquier proyecto o agente.
Sobre todo fuera de Github Copilot donde no existían las instructions.md, la gente buscaban una forma de resolver el problema de compartir conocimiento entre proyectos y agentes.
Lo bueno es que los skills son un estándar universal similar a AGENTS.md, así que los puedes usar en el agente que prefieras: Claude Code, OpenCode, GitHub Copilot, etc.
En Copilot Chat, el soporte de skills pasó de experimental a estable hace relativamente poco de la fecha en la que escribe este artículo.
Cómo instalar skills
Tienes varias formas de agregar skills a tu proyecto:
1. Manual — Copia el archivo SKILL.md directamente en la carpeta de skills de tu proyecto (e.g., .copilot/skills/mi-skill/SKILL.md). Funciona siempre, sin dependencias.
2. CLI de Vercel (skills.sh) — Vercel creó un ecosistema abierto de skills con un CLI que los instala con un solo comando:
npx skills add vercel-labs/agent-skills
El CLI descarga los archivos del skill desde GitHub y los configura automáticamente para tu agente.
3. CLI de Context7 — Context7 también ofrece un catálogo de skills instalables:
npx ctx7 skills install <owner/repo>
Ejemplos de skills
| Skill | Fuente | Qué hace |
|---|---|---|
vercel-react-best-practices |
vercel-labs/agent-skills | 40+ reglas de performance para React/Next.js, priorizadas por impacto. |
web-design-guidelines |
vercel-labs/agent-skills | Audita tu UI contra 100+ reglas de accesibilidad, performance y UX. |
Como activar skills de forma predecible
El agente activa un skill automáticamente cuando detecta que tu tarea coincide con su dominio — no necesitas invocarlo manualmente.
Cuando comencé a usar skills me daba cuenta que otras personas reportaban un efecto similar al mio, que a veces el skill no se activaba o que el agente parecía no usarlo. Incluso VSCode ofrece un setting Use Skill Adherence Prompt para obligar al agente a usar los skills de forma más predecible. Con el tiempo esto es menos común, supongo que con la adopción de los skills y actualizaciones de las herramientas.
Pero un consejo o buena practica para asegurar que esto no te pase es ser muy obvio y claro de cuando se debe activar un skill dentro del header de metadatos, piensa que ese header es lo único que el agente tiene para decidir si el skill aplica o no a la tarea.
---
name: technical-design-writer
description: |
  Use when the user explicitly asks to:
  - Create, write, or draft a "tech design", "technical design", "diseño técnico", or "technical design document"
  - Document a system design, architecture proposal, or implementation plan using a formal template
  - Follow a standard format for technical decisions with APIs, data models, and operational impact

  DO NOT use for: specs, ADRs only, slide presentations, diagrams only, or informal technical notes.

  This skill enforces a mandatory Markdown template with sections for: Summary, Context, Options, Detailed Design (APIs, data, code, PoC), Metrics, and Consequences.
compatibility: opencode
---
MCPs (Model Context Protocol)
Los MCPs llevan más tiempo en el ecosistema que los skills y también son parte del contexto dinámico. La diferencia: los skills le dan al agente conocimiento, los MCPs le dan capacidades. Con un MCP el agente puede hacer cosas y consultar fuentes externas que de otra forma no alcanzaría.
Un MCP es un estándar abierto que conecta agentes de AI con herramientas y servicios externos mediante un protocolo uniforme. En la práctica, un MCP server expone tools que el agente invoca directamente — buscar documentación, crear issues, consultar APIs, interactuar con bases de datos, etc.
Sin MCPs, un agente solo puede leer archivos y correr comandos en la terminal. Con MCPs, el alcance se multiplica:
- Acceso a documentación actualizada, en lugar de depender de datos de entrenamiento que pueden estar obsoletos.
- Interacción con servicios externos como Jira, GitHub, Confluence, bases de datos, APIs propietarias.
- Automatización de flujos: crear issues, abrir PRs, publicar páginas, todo desde el chat.
Ejemplos de MCPs
| MCP | Qué habilita | Ejemplo |
|---|---|---|
| Context7 | Documentación actualizada de +69,000 librerías inyectada directo en el prompt. Elimina alucinaciones de APIs inexistentes. | Crea un middleware en Next.js 14 que valide un JWT. use context7 |
| Atlassian | Crea/edita issues en Jira, publica en Confluence, busca con JQL — sin salir del editor. | Crea un issue en INS con título "Fix timeout en RFQ" |
| GitHub | Gestiona repos, issues, PRs, branches desde el agente. | Abre un PR con los cambios de esta sesión |
| Fetch | Lee páginas web arbitrarias para investigar o extraer información. | Investiga la API de Stripe en su página de docs |
[!tip] Skills vs MCPs
Skills MCPs Le dan al agente Conocimiento Capacidades Se activan Cuando la tarea coincide con su dominio Cuando el agente necesita una herramienta externa Ejemplo "Usa este patrón para tests" "Consulta la API de Jira" Formato Archivo SKILL.mden el repoServer externo con protocolo MCP
Instructions
Los instruction files de Copilot son archivos Markdown (.instructions.md) que agregas a tu proyecto para compartir conocimiento entre agentes y modos de programación. Se parecen a los skills en concepto, pero impactan el contexto de forma muy diferente.
Cuando empecé con Copilot, los instructions eran mi herramienta principal. Llenaba archivos con convenciones de código, patrones preferidos, reglas de linting, todo lo que quería que el agente "supiera" de antemano. Y funcionaban bien para establecer una base.
Pero con el tiempo, y sobre todo cuando llegaron los skills, los instructions me fueron dejando de hacer sentido. Los skills ofrecen lo mismo pero de forma más modular y portable. Y lo más importante: se activan solo cuando aplican, en lugar de cargarse siempre. (Obvio según applyTo)
Instrucciones no escalan
Puedes tener múltiples archivos de instrucciones, cada uno con un applyTo que define a qué archivos aplica. El problema aparece cuando:
- Los archivos son demasiado largos — Decenas de reglas, convenciones y ejemplos.
- Aplican a todo — Usar
applyTo: "**"los inyecta en cada conversación, sin importar el contexto. - Se acumulan — Varios archivos con scope amplio terminan sumando cientos o miles de tokens antes de que escribas una sola palabra.
Lo que debería funcionar como contexto dinámico se convierte en contexto estático. Presente siempre, ocupe o no.
La ventana de contexto es finita. Cada token que gastas en instrucciones es un token menos para:
- Leer tu código fuente.
- Analizar errores.
- Razonar sobre la tarea.
- Generar una respuesta de calidad.
Si saturas el contexto con instrucciones genéricas, el agente pierde atención sobre lo que realmente importa: tu tarea actual. Más instrucciones, menos calidad.
Cómo los uso yo
Mi caso de uso para los instruction files es casi mínimo. Unos cuantos bullet points — solo para ajustar cositas que la AI repetidamente hace raro o mal. Si detecto un patrón molesto, agrego un solo bullet para corregirlo y no agrego más contexto ahí. La idea es que sean correcciones minimas, no manuales de estilo.
Algo impresionante de los skills es que los puedes distribuir junto otros artefactos de contexto que el agente puede usar, ligeramente fragmentos de código, mas documentos md, etc. Un ejemplo notable es vercel-labs/react-native-skills el cual es un solo skill que se distribuye junto a otro folder de archivos md que fungen como reglas individuales que el agente puede consultar sin tener que cargar todas al contexto.
Ventana de contexto
La ventana de contexto es la cantidad máxima de tokens que un modelo puede procesar en una sola conversación. Esto incluye todo: instrucciones del sistema, archivos leídos, tu prompt y la respuesta generada. Dependiendo del modelo que uses, la ventana cambia. Por ejemplo, Claude Opus 4.6 en GitHub Copilot tiene 128K tokens.
Todo lo que hemos hablado (contexto estático, dinámico, skills, MCPs, instructions) compite por espacio dentro de esta misma ventana. Si la llenas rápido con instrucciones genéricas o conversaciones largas, al modelo le queda menos espacio para pensar en lo que le estás pidiendo.
La regla del 60–70%
Hay un consenso no formal entre programadores que trabajan con agentes de AI: conviene usar máximo el 60–70% de la ventana de contexto antes de abrir un chat nuevo. Pasado ese punto, la calidad se degrada. El modelo empieza a "olvidar" contexto temprano, pierde precisión y genera respuestas más genéricas.
[!example] Ejemplo: Claude Opus 4.6 (128K tokens)
Rango Tokens Estado 0–40% 0–51K Zona óptima. El modelo tiene espacio de sobra para razonar. 40–70% 51–90K Zona funcional. Aún hay calidad, pero empieza a costar. 70–100% 90–128K Zona de riesgo. Abre un chat nuevo.
Auto-compactación
Herramientas como Copilot y OpenCode ya tienen mecanismos que auto-compactan el contexto cuando la conversación se acerca al límite. El agente resume o descarta partes anteriores para liberar espacio y seguir funcionando. Es útil, pero no es magia. La compactación pierde detalle, así que no conviene depender de ella como estrategia principal.
Vibe Coding vs Spec Driven
Originalmente, el concepto de vibe coding como yo lo interpreto es un flujo de desarrollo basado en el Agent Build por defecto de tu herramienta de AI como primera y única instancia. A medida que salen las ideas, usas tu Build mode para ir desarrollando código.
Esto funciona bien. Pero puede llevar al desorden. Recordemos que el contexto es el rey: si tienes buenos skills, buenos prompts y archivos de instrucción justos, el vibe coding va muy bien para proyectos en general.
Para proyectos colaborativos es donde empieza la fricción. Sin embargo, el siguiente escalón natural hacia el orden es el patron Plan Mode → Agent Mode.
Todos hemos llegado a la conclusión de que rebotar ideas con AI a veces resulta en resolver el problema tú mismo. El efecto del rubber ducky.
Ahora bien, para un desarrollo estandarizado, escalable y consistente, existe Spec Driven Development. Hay muchos approaches que puedes tomar, desde usar solo Plan Mode y guardar eso en un archivo Markdown (Claude Code incluso agregó una funcionalidad para llevar el control de tus tasks en archivos .md), hasta usar frameworks completos como github/spec-kit o bmad.
Mi approach actual
Mi forma de hacer Spec Driven es a través de un agente que yo mismo personalicé. Unas pocas líneas de instrucción en un agente que me ayuda a crear archivos .md dentro de un folder tasks/, similar a lo que hace Claude Code. Por ahora me es suficiente.
Me pongo a rebotar ideas con mi agente "task-builder", usando referencias de código que mejoren la calidad del plan, y finalmente lo guardo en un archivo de texto .md que me ayuda a llevar un estado de avance de mis actividades.
Literalmente se ve como un TODO list que el mismo agente va palomeando:
# TASK-042: Migrar servicio de notificaciones a arquitectura serverless

## Contexto

El servicio actual de notificaciones corre en un ECS task dedicado.
Queremos moverlo a Lambda + SQS para reducir costos y simplificar el deploy.

## Tasks

- [x] Definir el esquema de eventos SQS para cada tipo de notificación
- [x] Crear Lambda handler con dead-letter queue
- [x] Migrar templates de correo a S3
- [ ] Implementar retry policy con backoff exponencial
- [ ] Agregar métricas de CloudWatch por tipo de notificación
- [ ] Actualizar integration tests
- [ ] Cleanup: eliminar ECS task definition y security groups viejos

## Notas

- El equipo de infra confirmó que el límite de concurrencia en Lambda es 500.
- Los templates actuales usan Handlebars, se mantienen igual.
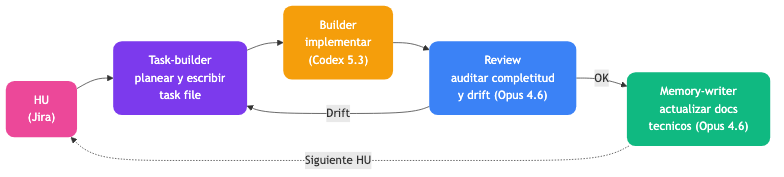
En cuanto tengo mi archivo de tasks escrito usando Opus 4.6, guardado y commiteado, le delego a Codex 5.3 implementar.
Al finalizar, regreso a Opus 4.6 y le hago una pregunta simple: que audite si la tarea realmente está completa o si detecta drift en la implementación.
Si todo sale bien, hago el commit final con los cambios implementados y borro el archivo de tasks. Para mí los task files son disposables: cumplen su función durante el desarrollo y después no los necesito.
El flujo se ve así:

Memorias a largo plazo
Otra pieza de mi Spec Driven Development son las memorias a largo plazo. Herramientas como spec-kit generan archivos llamados constitucion.md donde documentas los pilares del proyecto, y cada tarea generada debe satisfacerlos.
No uso spec-kit completamente, solo algunas partes. Lo que me gusta por ahora es que puede ser una técnica de adopción progresiva, porque la curva de aprendizaje del framework completo puede ser abrumadora.
En mi caso, con mis equipos, el ciclo funciona así: cada que se completa un documento de tareas (que nacen de las HUs de Jira), procuro a través de otro agente llamado "memory-writer" actualizar la documentación técnica o de arquitectura del proyecto. También uso Opus 4.6 para esa documentación.
El ciclo de desarrollo completo entonces se ve así:
Sé que existe un plugin para Claude Code que lleva una memoria a largo plazo. De mi lado aún no he implementado algo para hacer RAG de mis memorias, pero pienso que algún MCP que haga Vector DB puede ayudarme a extraer datos específicos sin cargar todo el documento al contexto.
Y aquí de nuevo, context is king.
[!abstract] Tasks vs Memorias
Tasks Memorias Ciclo de vida Nacen, se ejecutan, se borran Viven con el proyecto Mutabilidad Inmutables (se palomean, no se editan) Mutables (evolucionan cada iteración) Persistencia Disposables, el historial de git las respalda Persistentes en el repo Ejemplo TASK-042.mdarquitectura.md,decisions.md
Técnicas multi-agente
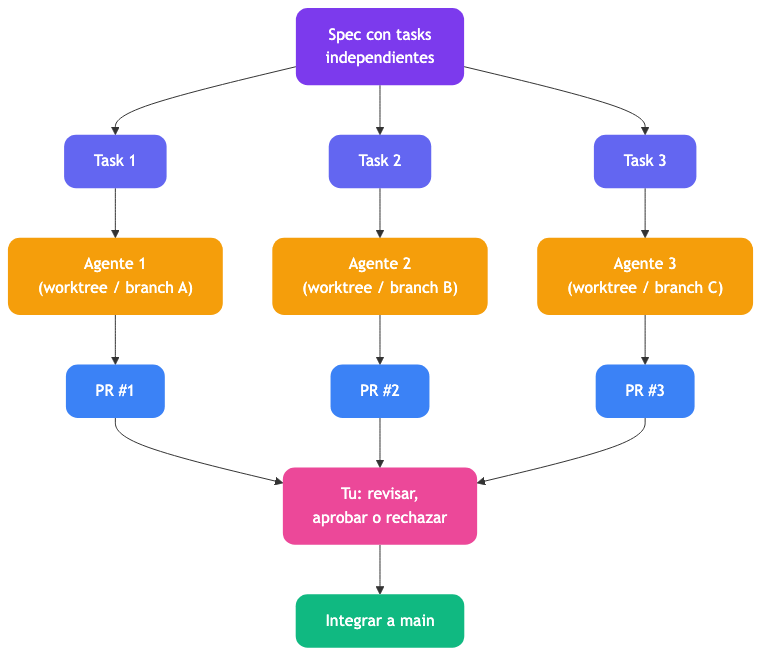
A este punto ya tenemos las bases y las reglas del juego establecidas. Gracias a las specs podemos distribuir el trabajo que no es dependiente entre sí. Los archivos de tasks deben ser ejecutables con la menor dependencia entre sí. Si logras eso, puedes escalar el flujo de trabajo.
GitHub Copilot ofrece la capacidad de correr agentes tanto en la nube como en background, trabajando en diferentes worktrees. Si nuestras tareas son independientes, podemos pedirle a Copilot que trabaje en diferentes branches y que cuando termine nos mande un PR para que nosotros podamos revisar, aprobar, rechazar o integrar.
Esta misma técnica se integra en herramientas como Codex de OpenAI, o herramientas open source como Conductor u OpenCode UI.
Pero no es algo que tú mismo no puedas hacer con algunos comandos e instrucciones personalizadas de agentes. Estas herramientas simplemente son mejores UIs para estas nuevas formas de trabajar.
Profundizando en patrones multi-agente
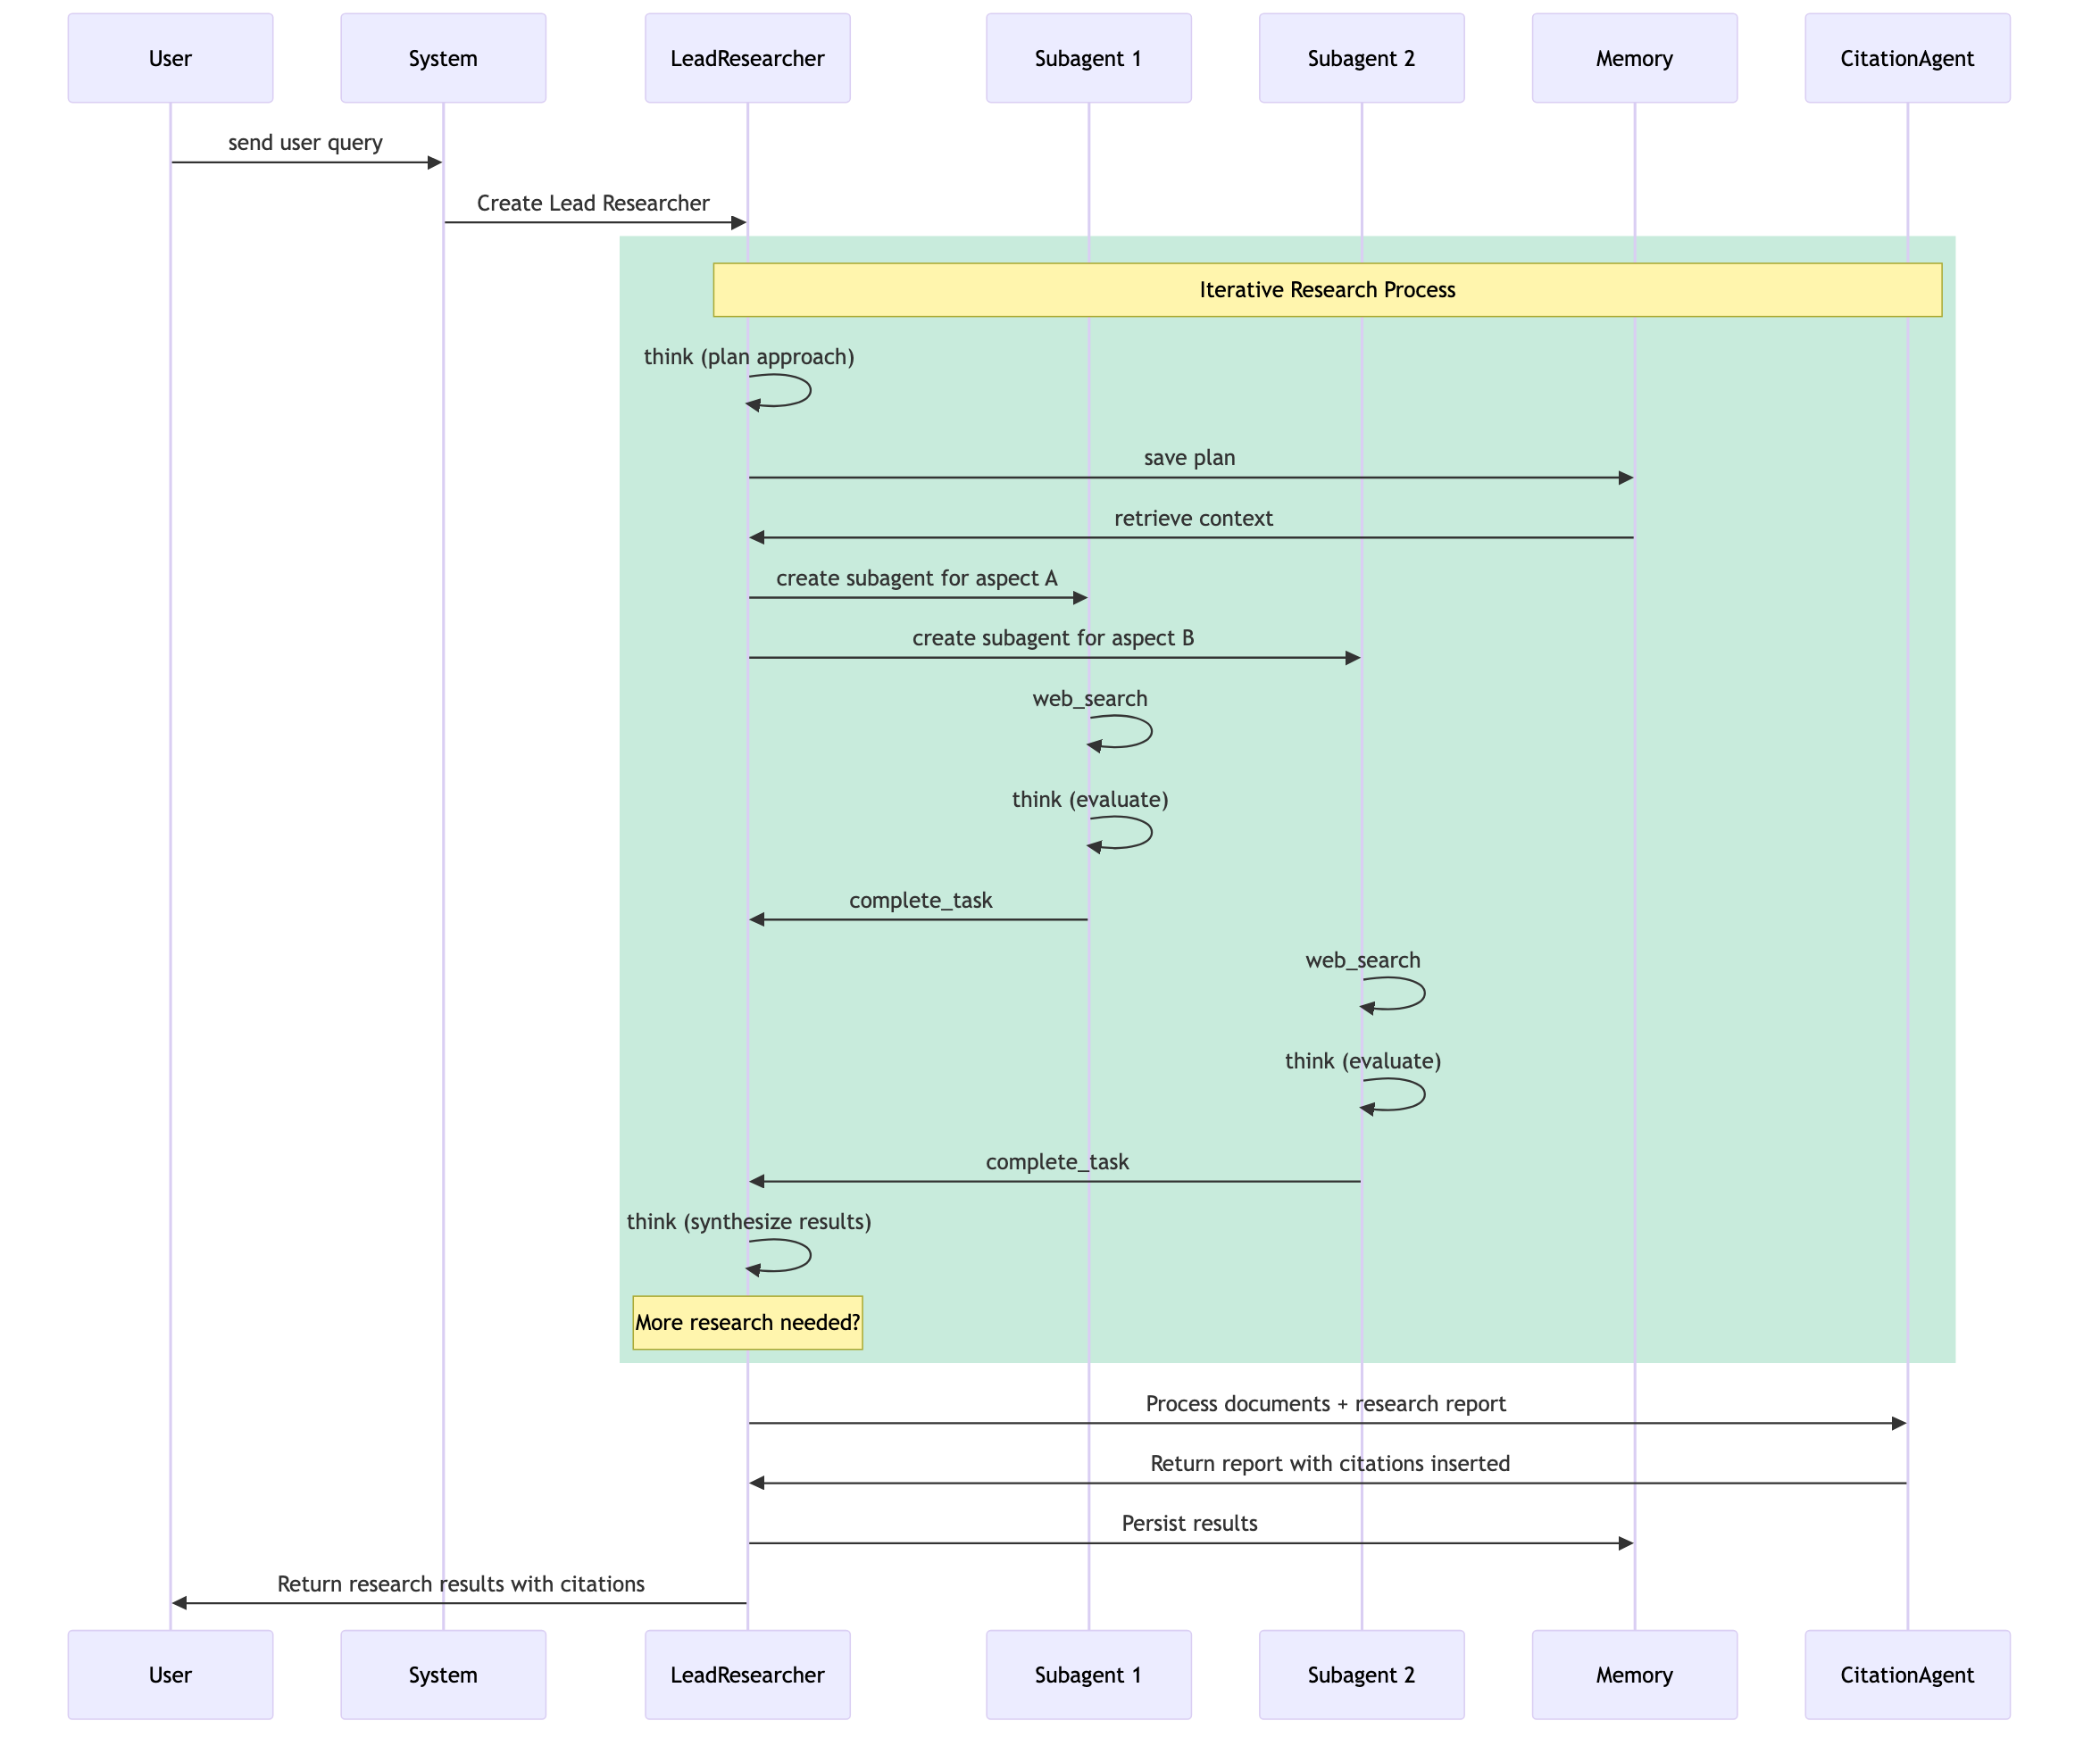
Desde aquel artículo de Anthropic sobre cómo disrumpieron una operación de espionaje con AI, he tratado de aprender y mejorar mis técnicas de desarrollo autónomas multi-agente. En otro artículo más enfocado sobre su sistema de investigación multi-agente, Anthropic muestra algunos patrones concretos para este tipo de desarrollo.
Anthropic describe un patrón donde un LeadResearcher orquesta subagentes especializados, cada uno con su propio contexto de ejecución, memoria compartida y un ciclo iterativo de investigación:
Workers: subagentes funcionales
Por ahora mi stack va así. Suelo tener subagentes "workers" encargados de tareas funcionales que no requieran más contexto o investigación: correr tests, extraer output de la consola, ejecutar scripts.
Estos subagentes te ayudan a ahorrar contexto del agente principal, porque cada uno crea su propio contexto de ejecución. El worker hace su trabajo, te regresa el resultado, y el agente principal no gasta tokens en toda esa ejecución intermedia.
Pipelines: orquestación de alto nivel
También tengo agentes de alto nivel que se encargan de orquestar. Por ejemplo, un pipeline tipo:
Challenger → Coder → Refactorer → Reviewer
Es el flujo de TDD pero orientado a agentes. El Challenger escribe los tests o define los criterios, el Coder implementa, el Refactorer limpia, y el Reviewer audita.
Routers: especialización por dominio
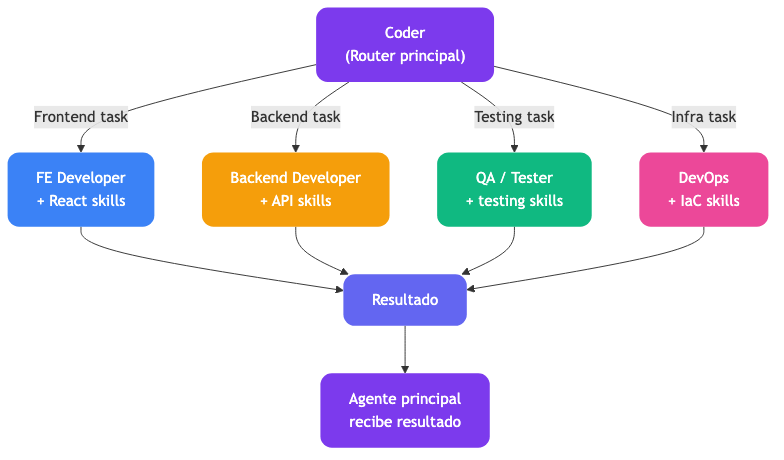
También puedes tener modelos router. Un Coder que enruta a diferentes subagentes o skills dependiendo del tipo de tarea. Si quieres que adquiera el arquetipo de FE developer, React developer, QA, Tester, etc., con subagentes creas contextos específicos de ejecución que los vuelven especialistas sobre un subject.
Competing Solutions
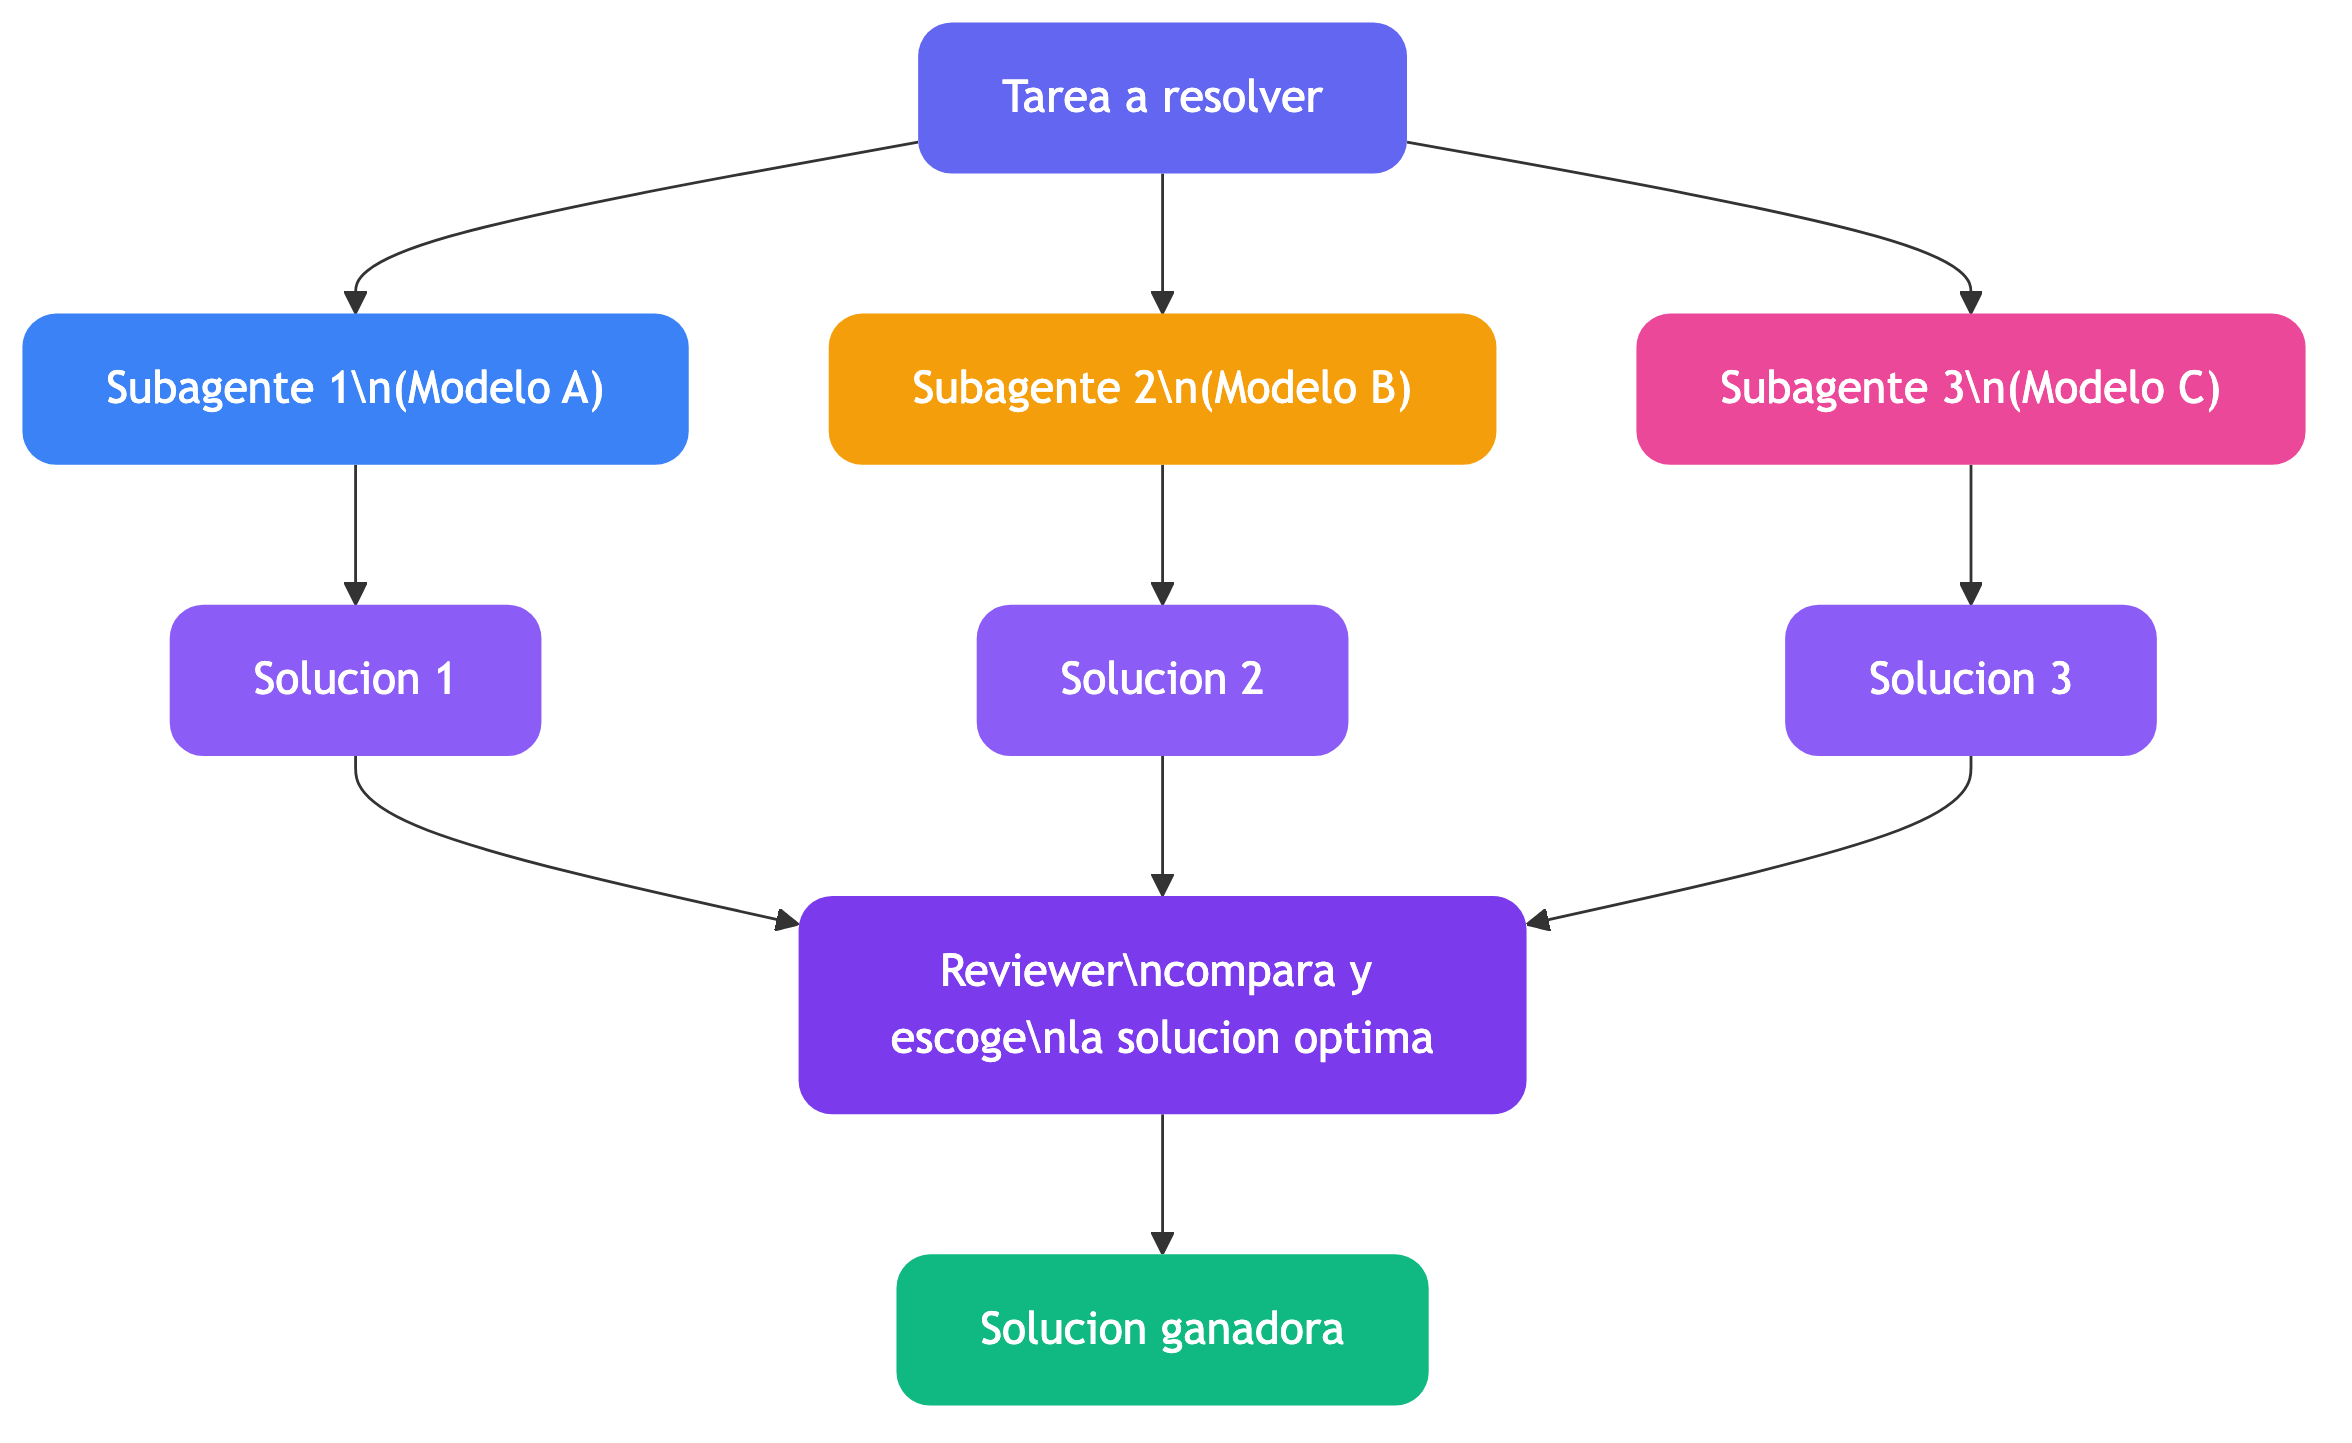
Otro patrón que me gusta es abrir múltiples subagentes que implementen la misma solución pero con diferentes modelos o approaches, y al final poner un revisor que escoja la más óptima. Es como hacer un concurso entre agentes: cada uno ataca el problema por su lado, y el reviewer final compara resultados y se queda con el mejor.
Agentes como pipelines
Yo ahora miro mis custom agents más como pipelines, como si de un CI/CD se tratara. Son pipelines para orquestar flujos de trabajo, y los skills, la memoria y las tasks son todo lo que los hace ricos en contexto.
Conclusión
Desde que aparecieron Copilot, GPT-3 y compañía, los flujos de trabajo han evolucionado en una dirección que para mí se resume en: cómo dejar de copiar y pegar con el modelo y, en su lugar, dejar que el modelo esté lo más cerca posible de lo que queremos que logre. Hoy con skills, MCPs, specs, memorias y pipelines multi-agente, esa distancia es cada vez más corta.
Pero lo curioso es que escribir código con agentes de AI es cada vez más parecido a simplemente escribir buen código. Las buenas prácticas de toda la vida siguen siendo las que mandan: código modular, reutilizable, documentado, testeado. Lo que cambió es quién las ejecuta y a qué velocidad.
Al final, la AI solo logró que los ingenieros finalmente escribieran sus pruebas y documentación, segmentaran su tren de pensamiento en pasos claros, y plasmaran todo eso en un recurso que cualquier persona pueda entender.
Qué sorpresa, ¿no?